
 KI News AI
KI News
Dein Prompt kostet fast nichts. Was auf dem KI-Kassenbon wirklich teuer ist
Input, Output, Cache Write, Cache Read: Auf der Rechnung einer KI-Session stehen vier Sorten Token. Teuer ist fast nie deine Frage, sondern das Gedächtnis. Mit unserem eigenen Kassenbon vom Website-Bau.
KI-Anbieter rechnen vier Sorten Token getrennt ab: Input, Output, Cache Write und Cache Read. In langen Sessions mit Claude Code, ChatGPT oder Gemini entfällt fast die ganze Rechnung auf den Cache, also darauf, dass das System bei jeder Antwort das gesamte bisherige Gespräch neu liest. Unser Website-Bau kostete in fünf Wochen rund 210 Dollar zum Listenpreis, davon 56 Prozent für Cache Reads. Ohne Cache wären es über 1.300 Dollar gewesen.
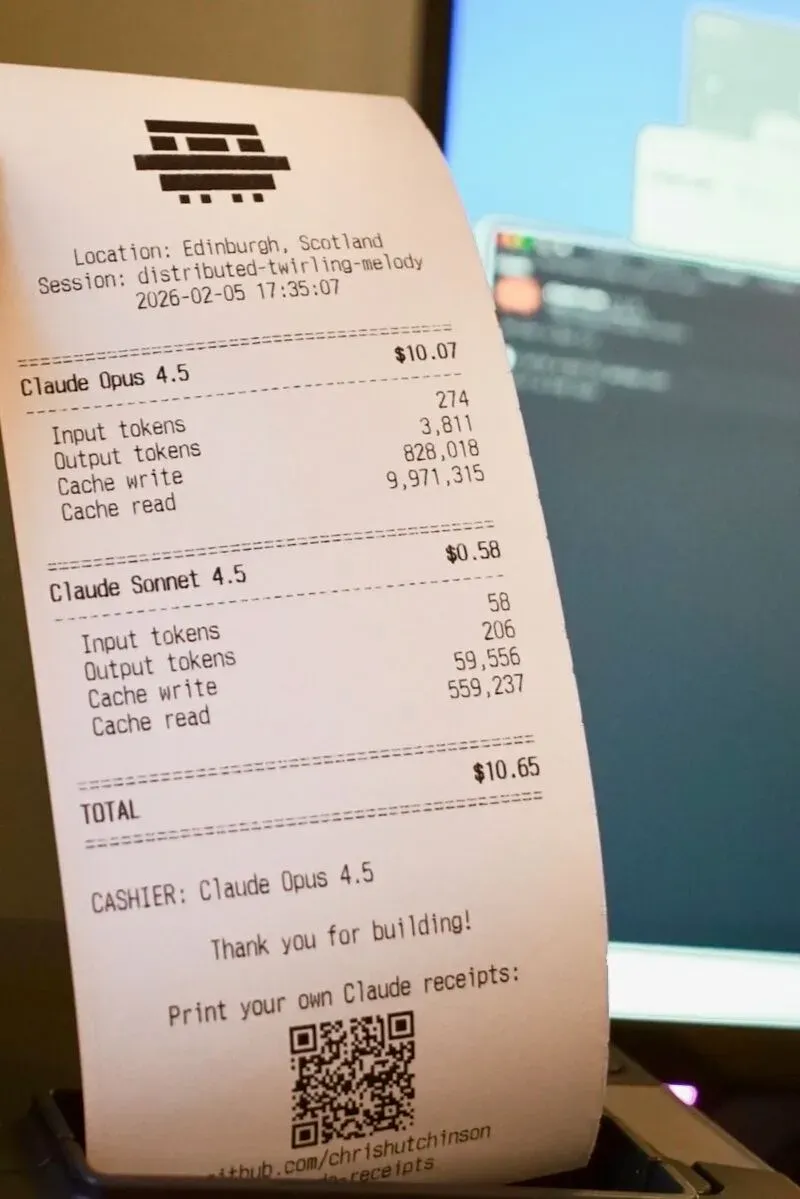
Meine Claude-Code-Sessions bekommen seit einer Weile einen Kassenbon. Sobald ich eine Session beende, druckt ein kleines Zusatzprogramm die Abrechnung aus. Bei mir nur digital, einen Bondrucker habe ich nicht. Chris Hutchinson aus Edinburgh hat einen, und von ihm stammt auch das Werkzeug. Sein Kommentar dazu: „It’s dumb, the receipts are beautiful, and I love it so much.”
Ich mag den Bon aus einem anderen Grund. Er zeigt auf einen Blick, was die meisten Menschen an KI-Kosten falsch verstehen. Auf Chris’ Bon stehen 274 Input-Token. Das ist ungefähr ein kurzer Absatz. Die Session hat trotzdem gut zehn Dollar gekostet. Bezahlt hat er also nicht seine Fragen. Bezahlt hat er das Gedächtnis.
Auf jeder KI-Rechnung stehen vier Sorten Token
Token sind die Recheneinheit von Sprachmodellen. Ein Token entspricht grob einer Silbe, im Deutschen etwas weniger als einem Wort. Abgerechnet wird pro Million Token. Und zwar nicht alle zum selben Preis, sondern in vier Sorten.
Am einfachsten verstehst du die vier Sorten mit einem Bild. Stell dir eine Kollegin vor, die brillant ist, aber kein Gedächtnis hat. Bei jeder neuen Frage musst du ihr die komplette Akte noch einmal vorlegen, inklusive allem, was ihr bisher besprochen habt. Genau so arbeiten KI-Systeme: Bei jeder Antwort liest das Modell das ganze Gespräch von vorn.
Input ist alles, was neu auf den Tisch kommt und nicht aus dem Gedächtnis stammt. Das ist der Basispreis.
Output ist alles, was die KI schreibt. Bei Claude kostet ein Output-Token fünfmal so viel wie ein Input-Token. Wichtig: Auch das Nachdenken vor der Antwort zählt als Output, selbst wenn du es nie zu sehen bekommst.
Cache Write heißt: Die Kollegin legt die Akte auf einen Stapel neben sich, damit sie beim nächsten Mal schneller ist. Dieses Ablegen kostet einen Aufschlag, bei Claude das 1,25-Fache des Input-Preises für fünf Minuten Haltbarkeit und das Doppelte für eine Stunde.
Cache Read heißt: Sie greift auf den Stapel zurück, statt alles neu zu lesen. Das kostet nur ein Zehntel des Input-Preises, bei den neuesten Claude-Modellen sogar nur ein Zwanzigstel.
Der Haken steckt im Wort „Stapel”. Er wächst mit jeder Runde. Und er wird bei jeder Runde komplett gelesen.
Rate mal: Welcher Posten war auf Chris' Bon am teuersten?
Fast ein Unentschieden zwischen den beiden Cache-Posten. Rechnet man den Opus-Teil mit den Listenpreisen nach, ergibt sich ungefähr dieses Bild:
| Posten | Token | Kosten |
|---|---|---|
| Input | 274 | 0,001 $ |
| Output | 3.811 | 0,10 $ |
| Cache Write | 828.018 | 5,18 $ |
| Cache Read | 9.971.315 | 4,99 $ |
Die 274 Token Input kosten ein Zehntel Cent. Fast 99 Prozent der Rechnung entfallen auf den Cache. Ohne Cache hätte dieselbe Session rund 54 Dollar gekostet.
Bezahlt wird das Gedächtnis, nicht die Frage
Viele Menschen denken bei KI-Kosten an ihre Prompts. Lange Prompts, teure Prompts. Das stimmt nur in einem einzigen Gespräch mit einer einzigen Frage. Sobald ein Gespräch länger wird, verschiebt sich die Rechnung komplett.
Das liegt an einem Detail, das kaum jemand kennt. Dein Prompt taucht auf dem Bon meist gar nicht als Input auf. Claude Code legt ihn sofort mit in den Cache, er erscheint also unter Cache Write. Als Input bleibt nur ein winziger Rest übrig. Deshalb stehen auf Chris’ Bon 274 Input-Token, obwohl er in der Session sicher mehr als einen Absatz geschrieben hat.
Teuer werden zwei Dinge. Erstens die schiere Menge an Cache Reads: Ein Agent wie Claude Code stellt pro Arbeitsschritt mehrere Anfragen, jede liest den ganzen Stapel. Zehn Millionen Token sind in einer langen Session schnell erreicht. Zweitens jede Pause. Ist der Cache abgelaufen, muss die komplette Akte neu abgelegt werden, zum teureren Write-Preis. Wer mittags eine Stunde weg ist und dann im selben Gespräch weitermacht, bezahlt das ganze Gespräch noch einmal.
Unser eigener Bon: fünf Wochen Website-Bau
Wir haben unsere neue Website mit Claude Code gebaut. Einen Kassenbon hatte ich dabei nicht. Ich brauchte aber auch keinen: Claude Code speichert jede Session lokal, inklusive der Token-Zahlen jeder einzelnen Antwort. Die habe ich nachträglich ausgewertet.
| Posten | Claude Opus 5 | Claude Opus 5.5 | Kosten gesamt |
|---|---|---|---|
| Input | 1.310 Token | 968 Token | 0,01 $ |
| Output | 684.731 Token | 360.928 Token | 24,34 $ |
| Cache Write | 5,3 Mio. Token | 2,3 Mio. Token | 67,83 $ |
| Cache Read | 210,8 Mio. Token | 62,7 Mio. Token | 117,92 $ |
| Summe | 172,29 $ | 37,82 $ | 210,11 $ |
Mehr als die Hälfte der Summe geht auf Cache Reads. Knapp ein Drittel auf Cache Writes. Output macht zwölf Prozent aus. Und Input? Ein Cent. In fünf Wochen.
Pro Arbeitstag ergibt das rund 12 Dollar. Anthropic selbst nennt für Unternehmen einen Durchschnitt von etwa 13 Dollar pro Entwickler und aktivem Tag. Ich liege also ziemlich genau im Schnitt, obwohl ich keine Entwicklerin bin.
Ehrlich gesagt ist das nur ein Ausschnitt. Claude Code löscht alte Sessions nach 30 Tagen, die ersten sechs Wochen des Projekts sind deshalb nicht mehr auf dem Bon. Außerdem zeigt er nur meinen Rechner. Den größten Teil der Arbeit haben Kathi und Artur Déchaud auf ihren eigenen Rechnern gemacht. Die echte Gesamtrechnung liegt also deutlich höher.
Wir rechnen über die Schnittstelle ab, also per API. Die 210 Dollar auf dem Bon sind deshalb kein Gedankenspiel. Wir haben sie bezahlt.
Im Abo füllt sich das Kontingent nach derselben Rechnung
Wer Claude, ChatGPT oder Gemini über ein Abo nutzt, bezahlt nicht pro Token. Der Dollarbetrag auf dem Bon ist dann ein Rechenwert zum Listenpreis. Davon solltest du dich aber nicht beruhigen lassen.
Abos haben Nutzungsgrenzen, und die füllen sich nach genau derselben Logik. Anthropic beschreibt das in der Dokumentation zu Claude Code sehr deutlich: Claude Code schickt bei jeder Anfrage das komplette Gespräch mit. Eine einzeilige Frage in einer Session, die seit dem Morgen offen ist, verbraucht deshalb Kontingent für das ganze Gespräch. Und die erste Nachricht nach einer Pause, die länger ist als die Haltbarkeit des Caches, verarbeitet den gesamten Kontext neu. Im Abo liegt diese Haltbarkeit bei einer Stunde.
Wer sich wundert, warum das Limit schon am Vormittag erreicht ist, findet die Antwort also fast immer in einem Gespräch, das seit Stunden offen ist. Der Bon zeigt dir dann nicht, was du bezahlst. Er zeigt dir, wie schnell du an die Grenze kommst.
Andere Anbieter rechnen nach derselben Logik
Das Prinzip ist kein Claude-Spezifikum. OpenAI und Google rechnen ebenfalls getrennt nach Input, Output und Cache. Die Details unterscheiden sich, die Größenordnung kaum.
| Claude | ChatGPT | Gemini | |
|---|---|---|---|
| Input | 1× | 1× | 1× |
| Output | 5× | 5× oder 6× | 6× |
| Cache Write | 1,25× oder 2× | 1,25× | 1× |
| Cache Read | 0,1× | 0,1× | 0,1× |
| Haltbarkeit | 5 Min. oder 1 Std. | 30 Min. | automatisch |
Wer Modelle über Anbietergrenzen hinweg vergleichen will, findet bei Artificial Analysis eine unabhängige Übersicht. Besonders hilfreich finde ich dort die Kosten pro Aufgabe. Sie zeigen, was ein Modell für eine typische Aufgabe tatsächlich verbraucht, aufgeschlüsselt nach Input, Denken, Antwort, Cache Write und Cache Hit. Das ist ehrlicher als der Preis pro Million Token. Ein günstiges Modell, das dreimal so lange nachdenkt, ist am Ende nicht günstig.
Token Maxxing ist Blödsinn
Token Maxxing, auch Tokenmaxxing geschrieben, heißt: Unternehmen belohnen ihre Mitarbeitenden dafür, möglichst viele KI-Token zu verbrauchen. Die Idee dahinter ist, dass mehr Nutzung mehr Ausprobieren und mehr Automatisierung bedeutet. Der Begriff spielt auf Internet-Slang wie „Looksmaxxing” an, also darauf, eine einzige Kennzahl ins Extreme zu treiben. Seinen Höhepunkt hatte der Trend laut IBM im Frühjahr 2026, seitdem flaut er ab.
Bekannt wurde er durch interne Ranglisten. Bei Meta gab es eine, die inzwischen eingestellt ist, mit Rängen wie „Token Legend” und „Session Immortal”. IBM berichtet außerdem von Amazon-Beschäftigten, die ihre Zahlen mit sinnlosen KI-Aufgaben aufgebläht haben. Das überrascht niemanden, der Goodharts Gesetz kennt: Sobald eine Kennzahl zum Ziel wird, taugt sie nicht mehr als Kennzahl.
Unser Bon zeigt, warum Token-Zahlen als Leistungsnachweis besonders wenig taugen. 56 Prozent unserer Rechnung entfallen auf Cache Reads. Das ist das Modell, das zum hundertsten Mal das bisherige Gespräch liest. Wer eine Session einfach den ganzen Tag offen lässt, landet weit oben in jeder Rangliste, ohne einen Handgriff mehr erledigt zu haben. Viele Token heißen nicht viel Arbeit. Oft heißen sie nur viel Ballast.
Warum das mehr ist als Buchhaltung
Ich halte den Kassenbon für ein unterschätztes Lernwerkzeug. Wer einmal gesehen hat, dass die eigene Frage einen Cent kostet und das Gespräch drumherum 200 Dollar, arbeitet anders. Nicht sparsamer im Sinne von „weniger KI”. Sondern bewusster: kürzere Gespräche, klarere Übergaben, weniger Ballast im Kontext.
Genau das meinen wir, wenn wir von AI Literacy sprechen. Zu verstehen, wie ein KI-System arbeitet, ist keine technische Spielerei. Es entscheidet darüber, ob du das Werkzeug steuerst oder ob es dich überrascht. Mit Energie und Wasser ist es übrigens ähnlich, dazu habe ich in „Ein Radieschen für 400 Token” geschrieben.
Und wenn du einen Bondrucker hast: Chris’ Werkzeug druckt auch auf Papier. Ich warte noch auf Weihnachten.
Weiterdenken
Ihr wollt aus News echte Kompetenz machen?
Im Bootcamp lernt euer Team, neue Modelle und Tools selbst einzuordnen, an euren echten Projekten statt an Featurelisten.
 AI
Promovierte KI-Forscherin, Geschäftsführerin von uncanny minds und Co-Autorin des O'Reilly-Buchs Content Marketing mit KI. Verantwortet Strategie, Text-KI und AI Literacy.
Weiterlesen
Das könnte dich auch interessieren.
- 01
 KI News
FLUX 3 Image
Black Forest Labs hat FLUX 3 Image veröffentlicht. Die Neuerung ist nicht die Bildqualität, sondern die Kontrolle: Bildaufbau per Bounding Box, Bearbeitungen, die den Rest des Bildes in Ruhe lassen, und native 4K.
- 02
 KI News
Jev von TypeSafe: Warum nicht jede Entscheidung ein Sprachmodell braucht
TypeSafe AI hat mit Jev ein Modell vorgestellt, das nicht schreibt, sondern entscheidet: Ja oder Nein, Option A oder B, Note 1 bis 5, jeweils mit Wahrscheinlichkeit. Was dahintersteckt, was es im Marketing-Alltag bringen könnte und warum „typsicher“ nicht „fehlerfrei“ heißt.
- 03
 KI News
Comfy Cloud MCP: Du promptest, Claude verkabelt
Der Comfy Cloud MCP verbindet Claude mit ComfyUI: Bilder, Videos und Workflows per Prompt statt Node-Graph. So richtest Du ihn in 5 Minuten ein.