
 KI News AI
KI News
Jev von TypeSafe: Warum nicht jede Entscheidung ein Sprachmodell braucht
TypeSafe AI hat mit Jev ein Modell vorgestellt, das nicht schreibt, sondern entscheidet: Ja oder Nein, Option A oder B, Note 1 bis 5, jeweils mit Wahrscheinlichkeit. Was dahintersteckt, was es im Marketing-Alltag bringen könnte und warum „typsicher“ nicht „fehlerfrei“ heißt.
Jev ist ein Modell von TypeSafe AI (Start am 15. September 2026), das keinen Text erzeugt, sondern typisierte Entscheidungen liefert: Choice (eine Option wählen), Score (auf einer Skala bewerten) und Noul (Ja/Nein als Wahrscheinlichkeit). Weil es nur über vorgegebene Antworten rechnet, kommt es in Millisekunden und zu einem Bruchteil der Kosten eines Sprachmodells zur Antwort, und Code kann direkt damit weiterarbeiten. Für Marketing eignen sich Posteingangs-Triage, Freigabe-Checks und Massenbewertungen. Der Haken: Die Antwort ist formal immer gültig, aber nicht automatisch richtig. Ein unabhängiges Paper zeigt, dass das Modell stark auf die Namen der Optionen reagiert. Die großen Geschwindigkeits- und Preisversprechen stammen bisher vom Hersteller.
Wenn du einen Newsletter-Entwurf schreiben lässt, kann ein Sprachmodell eine gute Wahl sein. Geht es aber nur darum, ob eine eingehende Mail eine Reklamation ist, ja oder nein, ist ein Sprachmodell zu viel des Guten: Es formuliert einen Absatz, obwohl ein Häkchen genügt.
Genau diesen Gedanken hat TypeSafe AI zu einem Produkt gemacht. Am 15. September 2026 hat das Unternehmen Jev vorgestellt und nennt es das erste „System One“-Modell. Es schreibt keine Texte. Es beantwortet Fragen mit einem Wert, den Software direkt weiterverarbeiten kann. Steve Nouri hat das auf LinkedIn mit der Formel zugespitzt: „LLMs generate. Jev decides.“
Ich erkläre dir in diesem Beitrag, was dahintersteckt, wie es technisch funktioniert, wo es im Marketing praktisch werden könnte und wo die Kritik berechtigt ist.
Was ist Jev? Kurz erklärt
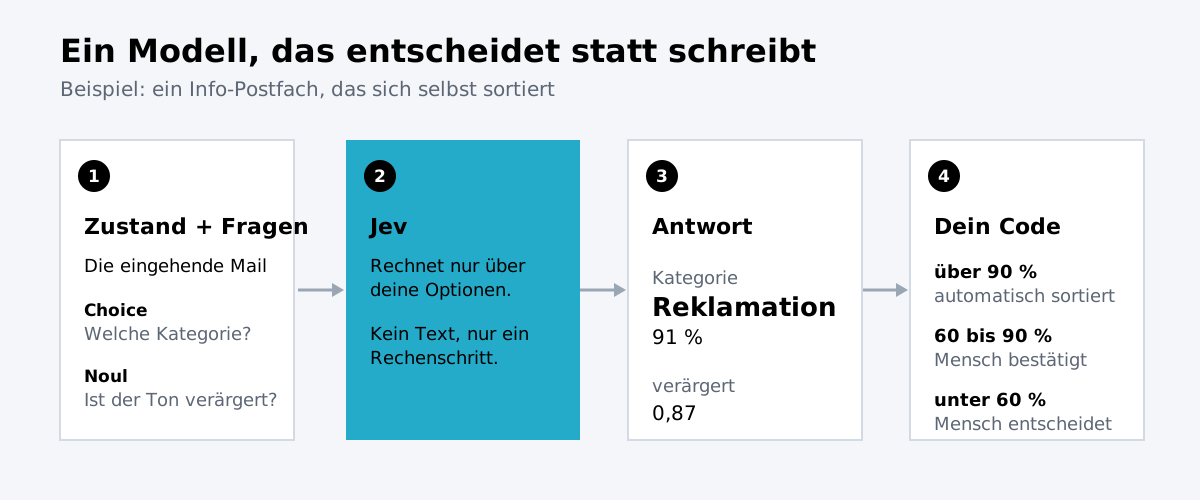
Jev ist ein KI-Modell von TypeSafe AI, das Entscheidungen trifft und keinen Text schreibt. Du gibst ihm eine Situation, zum Beispiel eine Kundenmail, und stellst eine Frage mit festen Antworten: Ist das eine Reklamation, eine Anfrage oder eine Presseanfrage? Jev antwortet mit einer Auswahl und einer Zahl, die sagt, wie sicher es sich ist, etwa „Reklamation, 91 %“. Ein Programm kann diese Antwort ohne Umwege weiterverarbeiten.
Ein Vergleich hilft: Ein Sprachmodell schreibt auf jede Frage einen Aufsatz. Jev hält eine Karte hoch, A, B oder C, und sagt dazu, wie sicher es ist. Solche Modelle heißen Entscheidungsmodelle, TypeSafe nennt sie „System One“-Modelle.
Jev läuft nur als gehostetes Angebot des Herstellers und ist seit dem 15. September 2026 verfügbar. Die Gewichte sind nicht veröffentlicht. Ob ein klassisches Sprachmodell darin steckt, hat TypeSafe nicht verraten. Dazu unten mehr.
Wie funktioniert Jev? Entscheiden statt Schreiben
Ein Sprachmodell erzeugt Text, Wort für Wort. Auch wenn du nur eine Ja/Nein-Antwort willst, bekommt dein Programm einen Satz zurück: „Ja, das scheint eine Reklamation zu sein, weil …“. Dann muss jemand diesen Satz auswerten. Das geht meistens gut und manchmal nicht, und es dauert und kostet mehr, als eine Entscheidung eigentlich müsste.
Die TypeSafe-Dokumentation, also das Handbuch des Herstellers, beschreibt das als Mismatch: Wenn dein Code die Entscheidung eines Modells verarbeiten soll, passt ein Freitext-Generator schlecht dazu. Jev dreht das um. Du gibst ihm einen Zustand (die Mail, das Dokument, die Situation) und typisierte Fragen. Zurück kommen keine Sätze, sondern Antworten in einem festen Format, mit Wahrscheinlichkeiten. Dein Code kann sie sortieren, verzweigen und weiterleiten, ohne etwas zu parsen.
„System One“ ist dabei ein Bezug auf Daniel Kahnemans Unterscheidung zwischen schnellem, intuitivem Denken (System 1) und langsamem, abwägendem (System 2). Sprachmodelle machen laut TypeSafe beides mit demselben teuren Apparat. Jev soll nur den schnellen Teil übernehmen.
Choice, Score, Noul: die drei Antworttypen von Jev
Alles, was Jev kann, besteht aus drei Antworttypen:
| Baustein | Frage | Antwort |
|---|---|---|
| Choice | Welche dieser Optionen passt? | Eine Wahl, Wahrscheinlichkeiten für jede Option, ein Konfidenzwert (laut TypeSafe-Dokumentation bis zu 255 beschriebene Optionen) |
| Score | Wie gut erfüllt das ein Kriterium? | Ein Wert auf einer Skala mit 2 bis 10 beschriebenen Stufen, auch Zwischenwerte |
| Noul | Stimmt diese Aussage? | Eine Wahrscheinlichkeit zwischen 0 und 1; nahe 0,5 heißt „ich bin unsicher“ |
Mehrere Fragen lassen sich in einem Aufruf stellen und laufen parallel. Die TypeSafe-Dokumentation rät dazu, atomar zu fragen. Statt „Bewerte diesen Pitch“ stellst du drei kleine Fragen: Ist der Markt groß genug? Ist es machbar? Gibt es Differenzierung? Wie du die Antworten gewichtest und zu einem Urteil verrechnest, entscheidet dein Code, nicht das Modell.
Jev-Architektur: Was steckt hinter dem Entscheidungsmodell?
Die Architektur erklärt sowohl die Stärken als auch die Schwächen von Jev, deshalb gehen wir sie Schritt für Schritt durch.
1. Der eingeschränkte Entscheidungskopf. Ein normales Sprachmodell berechnet am Ende für jedes Wort seines Vokabulars, wie wahrscheinlich es als Nächstes kommt. Beim offenen Modell Qwen2.5, das Hyperstack für einen Nachbau des Prinzips benutzt hat, sind das rund 151.000 Einträge. Bei Jev wird laut Hersteller nur für die Antworten gerechnet, die du vorgegeben hast. Bei drei Optionen sind das drei Werte statt 151.000, und daraus entstehen die Wahrscheinlichkeiten. Es wird kein Text erzeugt, nur ein einziger Durchlauf gerechnet. Hyperstack nennt dieses Verfahren restricted softmax. TypeSafe selbst spricht von einer „neuen Modellarchitektur“ mit einem „parallel sampler“, der alle Antworten in einem Durchgang liefert.
Daraus folgt zweierlei. Das Modell kann keine Antwort außerhalb deiner Liste geben, „typsicher“ ist also mathematisch garantiert. Und es ist schnell, weil das Wort-für-Wort-Erzeugen wegfällt.
2. Was darunter steckt, weiß niemand außerhalb von TypeSafe. Jev sei kein Sprachmodell, sagt das Unternehmen. Ob ein Sprachmodell darin steckt, sagt es nicht. Basismodell, Größe und Aufbau sind nicht veröffentlicht, die Gewichte ebenfalls nicht. Bekannt ist nur, dass Jev laut DigitalOcean zwei Jahre lang ausschließlich mit synthetischen Daten trainiert wurde, also mit künstlich erzeugten Beispielen. Außenstehende vermuten ein Transformer-Modell auf Basis eines offenen Sprachmodells. Bestätigt hat TypeSafe das nicht. Ich halte es für plausibel, weil das Prinzip mit vorgegebenen Antworten bei Sprachmodellen nachweislich funktioniert, wie der Nachbau von Hyperstack zeigt. Das bleibt aber eine Vermutung.
3. Eigenes Training. TypeSafe nennt das Verfahren Reinforcement Learning for Calibrated Decisions (RLCD). Belohnt wird nicht, was Menschen gut finden, sondern ob die angegebene Wahrscheinlichkeit zur Trefferquote passt. Wer „80 %“ sagt, soll in vier von fünf Fällen richtig liegen. Das ist der Kern des Versprechens: Man kann sich auf die Sicherheitsangabe verlassen und darauf Regeln bauen.
4. Die Arbeitsteilung im System. Nouri beschreibt drei Schichten, und ich finde das den nützlichsten Teil des ganzen Themas:
- Das Sprachmodell generiert und denkt tief nach.
- Jev routet, bewertet, schaltet frei oder blockiert und prüft.
- Code wendet die Regeln an und führt aus.
Oder kürzer: Die KI schätzt, der Code entscheidet nach Regeln, und Menschen kümmern sich um die Unsicheren. Diese Schichtung ist auch ohne Jev eine gute Idee.
5. Die Preise, laut Hersteller. 0,042 US-Dollar pro Million Eingabe-Token, also 42 Dollar pro Milliarde. Ausgabe kostet nichts, es gibt ja keine. Antwortzeiten von 70 bis 500 Millisekunden. Zum Vergleich nennt TypeSafe 0,20 bis 10 Dollar pro Million Token bei Sprachmodellen.
Jev im Marketing: Zwei Beispiele aus dem Alltag
Die folgenden Szenarien sind Denkmodelle, keine Kundenprojekte. Die Zahlen sind Beispielrechnungen mit dem Herstellerpreis.
Beispiel 1: Posteingang automatisch sortieren
Du betreust ein Info-Postfach, in das Anfragen, Reklamationen, Presseanfragen, Bewerbungen und Newsletter-Abmeldungen laufen. Heute sortiert das jemand von Hand, oder du lässt ein Sprachmodell jede Mail „lesen“ und einen Satz schreiben.
Mit einem Entscheidungsmodell sieht das so aus. Der Zustand ist die Mail. Die Choice-Frage lautet: Welche Kategorie ist das? Dazu kommt eine Noul-Frage: Ist die AbsenderIn verärgert? Zurück kommt zum Beispiel „Reklamation, 91 %“ und „verärgert, 0,87“.
Jetzt kommt der Teil, der den Unterschied macht, das Confidence Gate im Code:
- über 90 %: automatisch in die richtige Warteschlange
- zwischen 60 und 90 %: mit Vorschlag an einen Menschen zur Bestätigung
- unter 60 %: direkt an eine Person, ohne Vorschlag
Bei 10.000 Mails mit je etwa 500 Token wären das 5 Millionen Token, nach Herstellerpreis rund 21 Cent. Selbst wenn du den Faktor zehn drauflegst, ist das keine Budgetfrage mehr. Die Frage ist stattdessen, ob du den Schwellen vertraust. Dazu unten mehr.
Beispiel 2: Freigabe-Check für KI-Agenten
Immer mehr Teams lassen Agenten Dinge tun: Beiträge planen, Mails vorbereiten, Kampagnen anlegen. Je mehr ein Agent selbstständig macht, desto wichtiger wird die Frage, wann er einen Schritt wirklich ausführen darf. Nouri nennt das Tool-Call Gating.
Stell dir einen Agenten vor, der einen Newsletter versenden soll. Bevor er auf „Senden“ klickt, laufen ein paar atomare Fragen über den Entwurf:
- Noul: Enthält der Text ein Leistungsversprechen, das wir nicht belegen können?
- Noul: Wird eine KundIn genannt, die einer Nennung nicht zugestimmt hat?
- Score: Wie gut passt der Ton zu unserem Styleguide (1 bis 5)?
- Choice: Welche Zielgruppe ist gemeint: Bestandskunden, Interessenten, Presse?
Dein Code prüft dann: Alle Noul-Werte unter 0,1 und Ton mindestens 4? Dann darf der Agent senden. Sonst geht der Entwurf zur Freigabe. Das Modell schreibt hier nichts und entscheidet auch nichts allein, es liefert nur schnell und billig Messwerte für Regeln, die du selbst festgelegt hast. Genau das macht es kontrollierbar, und es lässt sich bei jedem Lauf tausendfach wiederholen, ohne dass die Kosten auffallen.
Ähnlich funktionieren andere Einsatzfelder, die Nouri aufzählt: Kommentare und Rezensionen in großer Menge bewerten, hundert Suchtreffer vorsortieren, bevor ein Sprachmodell sie zusammenfasst, oder kontinuierlich prüfen, ob die Antworten deines Chatbots noch gut sind, statt einmal im Quartal stichprobenartig.
Kritik an Jev: Wo das Entscheidungsmodell hakt
„Typsicher“ heißt nicht „fehlerfrei“
TypeSafe wirbt damit, Jev könne nicht halluzinieren, weil es nur aus vorgegebenen Antworten wählt. Das stimmt im engen Sinn: Es kann keine erfundene Option erzeugen. Aber es kann die falsche Option wählen, und zwar völlig formgerecht.
Selbst der Jev-begeisterte Beitrag von Nouri warnt davor, den Satz falsch zu verstehen. Die Hyperstack-Analyse formuliert es noch klarer: Ein Schema schließt eine Antwort außerhalb der Liste aus, sagt aber nichts darüber, ob die Antwort stimmt. Ein Login-Fehler, der als „Abrechnung“ einsortiert wird, ist typkonform und trotzdem falsch.
Ein Paper von Yu Sun und KollegInnen (arXiv 2609.26758) hat den Punkt hart getestet und trägt den Titel „Type-Safe Is Not Error-Free“. Die AutorInnen haben Optionen umbenannt, von „0/1“ zu „nein/ja“, während die eigentliche Bewertungsvorschrift gleich blieb. Bei 70,4 von 100 Antworten kippte das Ergebnis, und die Trennschärfe (AUC) fiel von 0,94 auf 0,23. Das ist kein Rauschen, sondern eine Umkehrung. Die Typfehlerquote blieb dabei durchgehend bei null. Der Befund: Der Entscheidungskopf folgt dem Namen der Option stärker als der Beschreibung, die du ihr mitgegeben hast.
Für die Praxis heißt das: Die Namen deiner Optionen beeinflussen das Ergebnis direkt. Nennst du sie „0“ und „1“, entscheidet das Modell anders, als wenn du sie „nein“ und „ja“ nennst, obwohl die Beschreibung dieselbe bleibt. Teste eine Benennung deshalb an echten Beispielen und ändere sie nicht nebenbei. Und ein Dashboard, das „0 Fehler“ meldet, misst hier nur das Format.
Wie schnell und günstig ist Jev wirklich?
TypeSafe nennt bis zu 200-mal schneller und 400-mal günstiger. Nouri schreibt selbst, dass das das obere Ende sei, und verweist auf konservativere unabhängige Berichte von etwa dem Hundertfachen.
Die einzige Messung, die ich gefunden habe und die man als Gegenprobe lesen kann, stammt von Hyperstack. Dort wurde der Mechanismus (restricted softmax) mit einem kleinen offenen Modell, Qwen2.5-0.5B, auf einer H100 nachgebaut: 463 Millisekunden pro Entscheidung gegenüber 848 bei normaler Textgenerierung, ein Faktor von 1,83. Das ist nicht Jev selbst, und das Modell ist winzig. Aber es zeigt, dass der Vorteil real und zugleich deutlich kleiner sein kann als der Werbefaktor. Ein Großteil der versprochenen Ersparnis kommt vermutlich daher, dass man Entscheidungen mit einem kleineren Modell erledigt, nicht allein aus dem Trick mit dem Entscheidungskopf. Das ist meine Einordnung, nicht die von TypeSafe.
Jev ist proprietär, jung und kaum unabhängig geprüft
Jev ist seit zwei Wochen am Markt. Die Kalibrierung, also die Frage, ob „90 %“ wirklich in neun von zehn Fällen stimmt, ist genau das, was du für ein Confidence Gate brauchst. Und sie ist bisher vor allem vom Hersteller selbst belegt. Dazu kommt Kontextempfindlichkeit: Irrelevante Zusatzinformationen im Zustand können die Genauigkeit senken. Wer auf Jev baut, baut auf ein proprietäres Modell, das man nicht selbst nachtrainieren oder prüfen kann.
Das Bewertungsproblem: Das Endergebnis stimmt, der Weg nicht
Das Paper „Jev for Scientific Decisions“ von Boyuan Deng und KollegInnen (arXiv 2609.24965) vergleicht zwölf Modellkonfigurationen an zwanzig Entscheidungsaufgaben aus zehn wissenschaftlichen Fällen. Jev landet bei der semantischen Korrektheit gleichauf mit fünf anderen Konfigurationen und hat die niedrigste mittlere Antwortzeit unter den erfolgreichen Antworten. Soweit die gute Nachricht.
Interessanter ist eine Beobachtung nebenbei: Bei drei Vergleichsmodellen führten sieben falsche Auswahlen bei einer einzigen Frage dazu, dass die nachfolgenden Zählungen falsch wurden, obwohl das Endergebnis richtig blieb. Die AutorInnen folgern, dass man bei solchen Systemen die Beziehungen und Mengen prüfen muss, die ein Workflow weiterverwendet, nicht nur das letzte Etikett.
Übertragen auf Marketing: Wenn dein Agent am Ende „Kampagne freigegeben“ sagt, weißt du noch nicht, ob unterwegs Segmente falsch gezählt oder Zielgruppen vertauscht wurden. Wer Entscheidungsketten baut, muss die Zwischenschritte prüfen.
Ist „System One“ eine neue Modellklasse?
Man kann einwenden, „System One“ sei vor allem ein neues Etikett für etwas, das es schon gibt: kleine spezialisierte Klassifikationsmodelle, die Ausgabe auf feste Labels einzuschränken, gibt es auch bei Open-Source-Modellen. Das ist ein berechtigter Punkt. Neu ist eher das Gesamtpaket: ein fertiges, kalibriert trainiertes Modell mit einheitlicher Schnittstelle, das sich wie ein Baustein in Code einfügen lässt. Ob das reicht, um eine eigene Modellklasse auszurufen, ist Geschmackssache.
Was Jev für Marketing und KI-Agenten bedeutet
Für die Technik: Der Gedanke, nicht jede Entscheidung dem großen Modell zu überlassen, ist unabhängig von Jev richtig. Wer Agenten baut, sollte Routing, Bewertung und Freigabe von der Textproduktion trennen. Das spart Geld, macht Abläufe schneller und lässt sich prüfen.
Für die Kontrolle: Der Wert liegt nicht im Modell, sondern in den Regeln, die du darum herum baust. Schwellenwerte, Eskalationswege, Stichproben. Ein Confidence Gate ist nur so gut wie die Kalibrierung dahinter, und die musst du für deinen Fall selbst messen: Zieh dir 200 Mails, die ein Mensch sortiert hat, und schau, was das Modell daraus macht.
Für die Verantwortung: Entscheidungen, die früher „in der Prompt-Blackbox“ verschwanden, werden zu Zahlen mit Schwellen. Das ist ehrlicher, weil man die Unsicherheit sieht. Es verschiebt aber auch die Verantwortung: Wer die 90-Prozent-Grenze festlegt, hat entschieden, wie viele Fehler in Kauf genommen werden. Das gehört ins Team, nicht in eine Konfigurationsdatei.
Für den Einstieg: Du musst dafür nicht auf Jev warten. Schreib dir für einen deiner Abläufe auf, welche Entscheidungen darin stecken, die im Grunde Ja/Nein oder Auswahl sind. Meist sind es mehr, als man denkt. Dann trennst du, was ein Modell schätzen darf, was Code regeln muss und was ein Mensch ansehen sollte. Diese Übung lohnt sich, egal welches Modell du danach einsetzt.
Fazit: Lohnt sich Jev für Marketingteams?
Jev ist ein interessanter Versuch, Sprachmodelle von einer Aufgabe zu entlasten, für die sie nie gedacht waren. Die Grundidee überzeugt mich. Bei den Zahlen würde ich abwarten, bis mehr Unabhängige nachgemessen haben, und bei „keine Halluzinationen“ genau hinsehen, was damit gemeint ist. Formal richtig ist nicht dasselbe wie inhaltlich richtig, und diese Lücke bleibt bei dir.
Quellen
- Steve Nouri auf LinkedIn: JEV Engineering, Stop Using an LLM for Every Decision
- TypeSafe: Dokumentation
- TypeSafe: Introducing System One Models & Jev
- Deng, Fan, Zhang, Xie: Jev for Scientific Decisions (arXiv 2609.24965)
- Sun, Xu, Shi, Yang: Type-Safe Is Not Error-Free (arXiv 2609.26758)
- DigitalOcean: What is Jev?
- Hyperstack: Jev, Inside TypeSafe AI’s First System One Decision Model
Weiterdenken
Ihr wollt aus News echte Kompetenz machen?
Im Bootcamp lernt euer Team, neue Modelle und Tools selbst einzuordnen, an euren echten Projekten statt an Featurelisten.
 AI
Humanbiologin mit Schwerpunkt Neurowissenschaften, seit 2024 bei uncanny minds. Verantwortet Content, Kommunikation und Community, betreut die Google Ads und entwickelt die Website. Arbeitet täglich mit KI-Agenten und schreibt auf, was davon funktioniert und was nicht.
Weiterlesen
Das könnte dich auch interessieren.
- 01
 KI News
Comfy Cloud MCP: Du promptest, Claude verkabelt
Der Comfy Cloud MCP verbindet Claude mit ComfyUI: Bilder, Videos und Workflows per Prompt statt Node-Graph. So richtest Du ihn in 5 Minuten ein.
- 02
 KI News
Wie deutsch ist Langdock wirklich?
Langdock gilt als deutsches KI-Startup. Doch die GmbH gehört zu 100 % einer US-Firma in Delaware. Warum das für Souveränität im Marketing zählt.
- 03
 KI News
Europäische KI-Alternativen im Test: unsere Übersicht für Marketing-Teams
Fable 5 war über Nacht weg – Zeit für europäische KI. EuroLLM, Mistral & 5 DSGVO-konforme Tools im ehrlichen Praxis-Check fürs Marketing.