
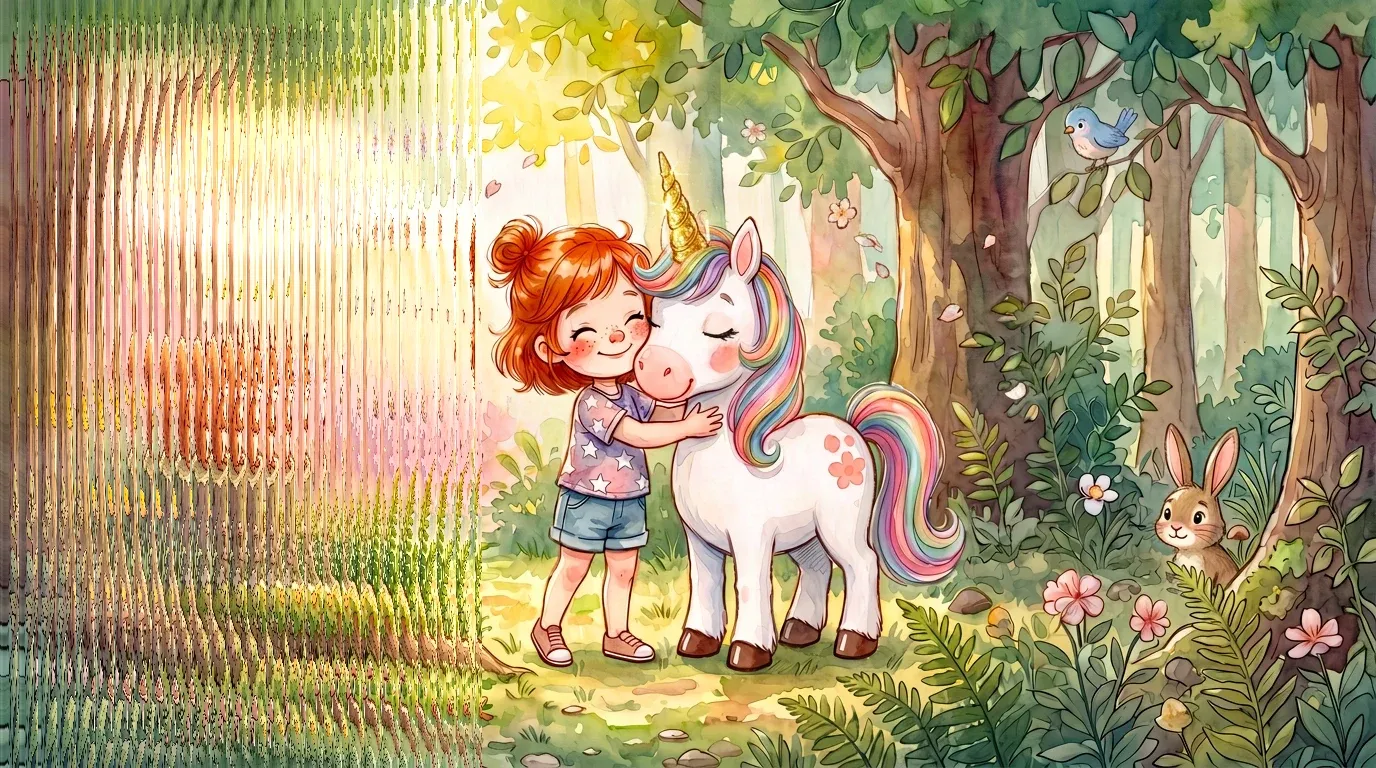
 KI im Einsatz AI
KI im Einsatz
Vom Kinderbuch zum Animationsfilm: mein kompletter Workflow mit Minimax H3, Nano Banana 2 und Claude
Aus dem Kinderbuch meiner Tochter ist ein Animationsfilm geworden. 34 Clips, 35 Stunden, komplett mit KI. Der ganze Workflow, mit drei Skills zum Herunterladen.
Aus 13 Doppelseiten eines Kinderbuchs wurden 34 Clips und ein Film von 4:10 Minuten. Startbilder aus Nano Banana 2, Animation in Minimax H3 in 2K, Konzeption und Prompts über Claude, das per MCP direkt in einen Magnific Space schreibt. Von 35 Stunden Arbeitszeit gingen unter drei aufs Generieren — die Zeit steckt in Konzeption, Prompts und Schnitt.
Vom Kinderbuch zum Animationsfilm: mein kompletter Workflow mit Minimax H3, Nano Banana 2 und Claude
Dieses Video liegt bei YouTube. Wenn Sie es laden, werden Ihre IP-Adresse und Angaben zu Ihrem Gerät an den Anbieter übertragen, der dabei auch Cookies setzen kann. Mehr dazu in unserer Datenschutzerklärung und in der Datenschutzerklärung von YouTube .
Zu Weihnachten 2025 habe ich meiner Tochter ihr eigenes Kinderbuch gemacht. Mit ihr als Hauptfigur, einem Pony, dem das Horn abgefallen ist, und einem Wald voller Figuren, die nichts Besseres zu tun haben, als zu helfen. Wie das Buch entstanden ist, habe ich hier aufgeschrieben: Kinderbuch mit KI erstellen
Neun Monate später gibt es einen Film daraus. Vier Minuten zehn, 34 Clips, komplett generiert.
Bildkonsistenz über Serien hinweg ist mein tägliches Geschäft. Charaktersheets, Referenzstrukturen, Modelltraining, das ist genau das, was wir für Kunden wie Bad Reichenhaller oder Flightright bauen. Was ich hier ausprobiert habe, ist die Frage dahinter: Was passiert, wenn man dieselbe Systematik auf 34 aufeinanderfolgende Videoclips anwendet, die eine durchgehende Geschichte erzählen müssen? Nicht ein hübscher Clip für einen Post. Ein Film, bei dem Szene 31 noch zu Szene 3 passt.
Private Projekte sind für mich die Testwiese dafür. Hier kann ich Modelle an die Wand fahren, ohne dass es einen Kunden Geld kostet, und ich kann so lange am Detail bleiben, wie ich will. Was dabei rauskommt, landet eine Woche später im Workshop.
Dieser Artikel ist so geschrieben, dass du den Film nachbauen kannst. Mit deinem eigenen Buch, deinem eigenen Kind, deinen eigenen Figuren.
Was dabei rausgekommen ist
| Laufzeit | 4:10 |
| Clips | 34, ein Shot pro Clip |
| Startbilder | Nano Banana 2, 4K |
| Video | Minimax H3, 2K |
| Erzählspur | 5 zusammenhängende Blöcke |
| Figurenstimmen | 18 Zeilen im Clip mitgeneriert, eine Zeile nachvertont |
| Arbeitszeit | rund 35 Stunden |
| Verteilt auf | 15 Arbeitstage über 6,5 Wochen |
Zur Einordnung: Vier Minuten Animation wären klassisch produziert ein Projekt über Monate mit einem kleinen Team. Das ist der eigentliche Punkt an der Sache. Ein einzelner Mensch kann so etwas heute zu Ende bringen, ohne dass es nach Bastelei aussieht.
| # | Schritt | Werkzeug | Zeitanteil |
|---|---|---|---|
| 1 | Buch in Szenen zerlegen, Drehbuch, Dauern | Claude | 20 % |
| 2 | Charaktersheets und Referenzbilder anlegen | Nano Banana 2 | 10 % |
| 3 | Startbilder im Zustand „davor" generieren | Nano Banana 2, 4K | 15 % |
| 4 | Videoprompts schreiben, je einer pro Clip | Claude | 10 % |
| 5 | Clips generieren, sichten, verwerfen | Minimax H3, 2K | 20 % |
| 6 | Erzählstimme und Musik bauen | ElevenLabs v3, Suno | 5 % |
| 7 | Schnitt und Feinschliff | CapCut | 20 % |
Der Stack, und warum genau dieser
Bild: Nano Banana 2
Für die Startbilder war Nano Banana 2 die Go-to-Lösung, und zwar aus einem sehr unromantischen Grund: Es ist ein günstiger Allrounder mit sehr guter Referenzbildtreue. Bei einem Projekt, in dem du pro Motiv vier Varianten ziehst und von 34 Motiven ungefähr zwölf mehrfach neu machst, summiert sich der Preis pro Bild zu einem echten Faktor.
Die Qualität reicht für Aquarelloptik locker. Ich habe durchgehend in 4K generiert, weil die Startbilder anschließend in die Videogenerierung gehen und jedes Detail, das im Startbild fehlt, im Video garantiert nicht dazukommt.


Video: Minimax H3, und der Sprung auf 2K
Angefangen habe ich mit Minimax H3 in 768p. Das war die Standardeinstellung, und für die ersten Tests völlig ausreichend.
Dann kam Clip 11a, eine Szene in der Zwergenwerkstatt mit einem Schild an der Wand. In 768p ist die Schrift auf dem Schild bei jedem Frame neu zerfallen. Ich habe denselben Clip in 2K nachgezogen, und das Ergebnis war nicht einfach schärfer. Es war ein anderer Clip.
Der Detailgrad steigt erwartbar. Was mich überrascht hat: Auch die Generierungsqualität an sich wird besser. Bewegungen sitzen sauberer, Hände zerfließen seltener, Gesichter bleiben über die Clipdauer stabiler. Offenbar hängt an der höheren Auflösung mehr als nur die Pixelzahl.
Seitdem läuft bei mir alles in 2K, was ins fertige Ergebnis soll. 768p ist die Testauflösung, mit der ich prüfe, ob ein Prompt grundsätzlich funktioniert. Sitzt die Bewegung, wird in 2K nachgezogen. Das spart Credits an der richtigen Stelle, nämlich bei den Versuchen, die ohnehin im Papierkorb landen.

Der Rest
Claude für Konzeption, Drehbuch, Prompts und die gesamte Verwaltung. Magnific Spaces als Werkbank. ElevenLabs v3 für die Erzählstimme. Suno für die Musik. Geschnitten habe ich in CapCut, aber dazu unten mehr, das ist die Stelle, an der ich es beim nächsten Mal anders machen würde.
Das eigentliche Setup: Claude schreibt direkt in den Space
Das ist der Teil, der diesen Workflow von „ich prompte halt was” unterscheidet.
Ich habe Claude über MCP direkt an Magnific angebunden. Das heißt: Ich bespreche die Konzeption im Chat, und dieselbe Konversation legt die Bilder an. Kein Copy-Paste zwischen Tabs, kein Prompt, der beim Übertragen verloren geht, keine Datei namens prompts_final_v3_wirklich_final.txt.
Was ist MCP?
Model Context Protocol. Eine offene Schnittstelle, über die ein Sprachmodell externe Werkzeuge direkt bedienen kann. Statt dass Claude dir einen Prompt ausgibt, den du irgendwo einfügst, ruft Claude die Bildgenerierung selbst auf, bekommt das Ergebnis zurück und arbeitet damit weiter.
Praktisch heißt das: Du redest über deine Szene, und am Ende des Satzes liegt das Bild da. Für seriellen Content ist das der größte Zeitgewinn der letzten zwei Jahre, und zwar nicht wegen der Geschwindigkeit, sondern weil nichts mehr zwischen Konzeption und Umsetzung verloren geht.
Der entscheidende Kniff dabei, und den würde ich jedem ans Herz legen:
Der MCP soll das sauber in einem Space aufbauen, nicht einfach nur Bilder ausspucken.
Ein Space ist eine Arbeitsfläche, auf der Referenzbilder, Prompts und Generatoren als Knoten nebeneinander liegen und verdrahtet sind. Wenn Claude dort strukturiert arbeitet, bekommst du eine Werkstatt statt eines Haufens Dateien. Mein Aufbau war eine Zeile pro Clip:


Der Punkt dabei ist nicht die Ordnung an sich. Der Punkt ist, dass du jederzeit selbst eingreifen kannst. Und du wirst eingreifen wollen.
Bei mir sah das so aus: Claude baut die Struktur und schreibt die Prompts. Ich schaue mir die Ergebnisse an, tausche ein Referenzbild aus, retuschiere ein Startbild von Hand, ziehe eine Variante nach. Die Sammellisten pro Zeile behalten dabei alle Versionen, die ich gut fand. Wenn ich drei Tage später merke, dass Variante zwei doch besser war, ist sie noch da.
Wer die Generierung komplett durchautomatisiert, verliert genau diese Möglichkeit. Und bei einem Projekt, das über Wochen läuft, ist das der Unterschied zwischen einem Werkzeug und einem Automaten.
Die Prompt-Regeln, die bei H3 wirklich zählen
Die meisten davon sind bekannte Best Practices aus der Bild-KI. Was sich ändert, ist ihre Schärfe. Was bei Einzelbildern eine Empfehlung ist, wird bei 34 zusammenhängenden Clips zur harten Regel.

Das Startbild ist Frame 0
Frame 0
Das Startbild ist nicht die Illustration der Szene. Es ist das erste Einzelbild des Clips, also der Zustand unmittelbar bevor die Handlung passiert. Alles, was im Startbild schon geschehen ist, kann der Clip nicht mehr zeigen.
Buchillustrationen zeigen den Höhepunkt. Das Horn klebt am Pony, alle jubeln, fertig. Als Startbild ist so ein Motiv wertlos, weil das Modell nichts mehr zu tun hat.
Das Startbild muss den Zustand davor zeigen: Der Zwerg hält das Horn noch in der Hand, die Ponystirn ist kahl. Dann hat der Clip etwas zu erzählen.


Sieben meiner Startbilder habe ich aus genau diesem Grund neu generiert. Das ist der teuerste Denkfehler in dieser Disziplin, und er passiert besonders gern denen, die aus dem Grafikbereich kommen. Wir sind darauf trainiert, das aussagekräftigste Bild zu wählen. Für Video ist das exakt die falsche Auswahl.
Ein Sonderfall, der sich bewährt hat: Wenn Figuren in eine Szene hineinlaufen sollen, brauchst du ein Startbild ohne sie. Bei meiner Zwergenmine habe ich ein zweites Bild mit leerem Hof angelegt, damit Mathilda und das Pony im Clip hereinkommen können, statt von Anfang an dazustehen.
Was du nicht beschreibst, bewegt sich nicht
Ein gemalter Marienkäfer auf einem Blatt sitzt den ganzen Clip regungslos da, wenn im Prompt nichts über ihn steht. Das Modell animiert genau das, was du benennst, und behandelt den Rest als Tapete.
Jedes sichtbare Element braucht eine beschriebene Bewegung. Jeder Clip braucht einen beschriebenen Ton. Das macht Prompts lang und unromantisch, ist aber der Unterschied zwischen einem lebendigen Bild und einem teuren Standbild mit Wackeln.
Wer einen Mund im Bild hat, spricht
Das Modell hängt gesprochene Sprache an den Mund, den es findet. Wenn deine Hauptfigur von hinten zu sehen ist und daneben steht ein Pony frontal im Bild, spricht das Pony.
Regel daraus: Soll eine bestimmte Figur sprechen, muss ihr Gesicht im Bild sein. Ist es das nicht, kriegt sie den Satz nicht.
Das hat übrigens eine angenehme Konsequenz für die Regie. Bei einer Szene, in der Mathilda zum Riesen hochspricht, hatte ich sie zunächst zur Kamera gedreht, damit man ihr Gesicht sieht. Sah aus, als würde sie sich vom Riesen wegdrehen. Die Lösung war nicht, die Figur zu drehen, sondern die Kamera: ein leichter Schwenk nach links, beide im Profil, Blickrichtung stimmt, Mund sichtbar.

Zwei Prompt-Formate, je nach Verdrahtung
Ref2VA und FL2VA
Ref2VA heißt: Du gibst dem Modell mehrere Referenzbilder mit (Figuren, Ort, Requisiten) und beschreibst die Szene. Das Modell baut die Bewegung selbst.
FL2VA heißt: Du gibst ein erstes und ein letztes Bild vor, und das Modell interpoliert den Weg dazwischen. Nützlich, wenn ein bestimmter Endzustand erreicht werden muss.
Wichtig: Beides gleichzeitig geht bei H3 nicht. Sobald du Keyframes setzt, sind Referenzbilder gesperrt, und der Prompt muss komplett anders aufgebaut sein. Ein FL2VA-Prompt beschreibt den Bewegungsweg, nicht zwei Standbilder.
33 meiner Clips laufen als Ref2VA. Einer als FL2VA, weil dort ein exakter Endzustand nötig war.
Negativ-Prompts holen rein, was du raushaben willst
Für ein Close-up hatte ich eine lange Ausschlussliste gebaut: kein dies, kein das, auf keinen Fall jenes. Ergebnis war zuverlässig Murks. Kurze, positiv formulierte Prompts haben danach auf Anhieb funktioniert.
Das ist keine neue Erkenntnis, gilt aber bei Videomodellen noch strenger als bei Bildmodellen, weil dort jede Nennung auch noch die Bewegung beeinflusst.
Wo die Modelle danebengreifen
Das Unterhaltsamste am Projekt. Und lehrreich, weil sich aus jedem Fehlgriff eine Regel ableiten lässt.


Der Biber und die Säge. Der Biber sollte neugierig gegen das Horn klopfen, nachdem Mathilda ihn gefragt hat. Im ersten Durchlauf klopfte er wie ein Specht und zwar lange bevor irgendwer etwas gefragt hatte. Ursache: Ich hatte das Klopfen beschrieben, ohne die Reihenfolge festzunageln. Modelle bauen Handlungen gern parallel statt nacheinander. Seitdem schreibe ich Abläufe explizit sequenziell.
Der glühende Biber. In einer Szene sollte das Horn golden aufblitzen. Was glühte, war der Biber. Wenn du einen Lichteffekt beschreibst, sucht sich das Modell das Objekt dafür oft selbst, und zwar gern das größte im Bild. Ich habe den Effekt am Ende komplett gestrichen und ihn im Schnitt ergänzt.
Der grimmige Riese. Das Startbild zeigte ihn mit finsterem Gesicht, weil er aus der Ferne heranstapft. Im Clip sollte er beim Entdecken der beiden zu lachen anfangen. Das Modell hat den Gesichtsausdruck aus dem Startbild als Vorgabe für den ganzen Clip gelesen. Lösung: Den Stimmungswechsel ausdrücklich als Ablauf beschreiben, inklusive des Moments, in dem er kippt.
Das Keinhorn mit Horn. Bei der Bildgenerierung hatte ich mehrfach das Problem, dass ein Pony ohne Horn entweder doch eines bekam oder seltsam proportioniert aussah. Grund: Das Wort „unicorn” im Prompt zieht das Horn mit. Auch eine Verneinung hilft da nicht, im Gegenteil. Die Lösung war, das Tier schlicht als Pony mit bunter Mähne zu beschreiben und das Horn nie zu erwähnen.
Die unsichtbare zweite Tonspur. H3 generiert Ton mit. Wenn du im Soundscape-Abschnitt auch nur das Wort „Stimmen” erwähnst, legt das Modell eine zweite Sprachspur an, und die fällt auf Englisch mit erfundenem Text zurück. Der Abschnitt für Umgebungsgeräusche muss komplett frei von allem sein, was nach Sprache klingt.
Die verratene Pointe. H3 arbeitet mit einem Zusammenfassungsfeld, in dem du den Clip in einem Satz beschreibst. Steht dort sinngemäß, was die Figur sagt, spricht die Figur diese Zusammenfassung statt des eigentlichen Dialogs. Ich schreibe dort inzwischen einen bewusst inhaltsfreien Satz.
Die Content-Moderation. Eine Szene mit einem beschriebenen sechsjährigen Mädchen und einem weinenden Pony ist mir zweimal durchgefallen. Kein Vorwurf, die Filter müssen scharf stehen. Aber wer mit Kindern arbeitet, sollte damit rechnen und einen Plan B haben. Bei mir läuft der Satz jetzt über eine separat generierte Tonspur, die ich über den stummen Clip lege.
Der Ton
Der Film hat zwei Sprachebenen, und sie entstehen völlig verschieden. Der Erzähler kommt aus ElevenLabs und liegt als eigene Spur über dem Schnitt. Die 18 Figurenzeilen entstehen im Clip, von H3 mitgeneriert, und sind damit untrennbar mit dem Bild verbunden.
Der Erzähler
19 Einsätze, viele davon nur ein Satz lang. Einzeln generiert klang jede Datei anders, weil ElevenLabs v3 unter rund 250 Zeichen unzuverlässig wird und die Stimmfarbe springt.
Die Lösung waren fünf zusammenhängende Blöcke, jeder über 250 Zeichen, mit Leerzeilen an den Schnittstellen. Die Leerzeile erzeugt eine hörbar längere Pause, an der sich sauber schneiden lässt. Aus 19 wackeligen Dateien wurden fünf stabile. So sieht der erste Block aus:
Eines Tages geht Mathilda im Wald spazieren.

Doch heute bleibt sie plötzlich stehen. [curious] Was sitzt denn da im Gras?
[excited] Ein weißes Pony mit bunter Mähne!

Das Pony schluchzt nur und senkt den Kopf. [whispers] Da entdeckt Mathilda
etwas Goldenes im Moos.

[warmly] Und plötzlich versteht sie, was passiert ist.
Dass die Erzählspur separat liegt, hat einen zweiten Nutzen, der beim Schneiden wichtiger wurde als gedacht: Sie darf über Schnittgrenzen laufen. Ein Satz, der auf dem letzten Drittel von Clip A beginnt und auf Clip B endet, bindet die beiden zusammen. Genau damit habe ich die Stellen entschärft, an denen die Geschichte sprang.
Audio-Tags bei ElevenLabs v3
v3 versteht Regieanweisungen in eckigen Klammern mitten im Text:
[warmly],[whispers],[laughs],[curious].Zwei Dinge, die man wissen muss: Die Tags werden auf Englisch geschrieben, auch wenn der gesprochene Text deutsch ist. Und sie funktionieren nur innerhalb des Charakters der gewählten Stimme. Eine sanfte Märchenstimme wird durch
[shouting]nicht laut, sie wird seltsam.
Die Figurenstimmen
Die hätte ich auch alle über ElevenLabs machen können. Habe ich bewusst nicht, denn die Lippenbewegung sitzt nur dann, wenn das Modell den Satz selbst spricht. Nachvertonen heißt Nachsynchronisieren, und das sieht man.
Dafür gelten drei Regeln, die ich auf die harte Tour gelernt habe.
Das Tempo ist gedeckelt. Mehr als 1,3 Wörter pro Sekunde Clipdauer verschluckt oder hetzt das Modell. Eine Zeile mit zehn Wörtern braucht also knapp acht Sekunden Clip. Diese Rechnung bestimmt die Clipdauern, nicht umgekehrt — und wer sie überspringt, merkt es erst beim fertigen Clip.
Wer einen Mund im Bild hat, spricht. In einer Szene sollte Mathilda einen Satz sagen, gesprochen hat ihn das Pony. Sie war von hinten zu sehen, das Pony frontal, und das Modell hängt die Sprache an den Mund, den es findet.
Je weniger Münder, desto sauberer. Bei den drei Zwergen, die gemeinsam jubeln, habe ich auf einen Sprecher umgestellt. Drei gleichzeitig bewegte Münder werden unweigerlich ungenau, und mit einer Stimme lässt sich hinterher auch der ElevenLabs Voice Changer ansetzen, falls die Färbung nicht passt.
Überraschend war, wie konsistent Mathildas Stimme über 34 Clips geblieben ist, obwohl sie nirgends festgelegt ist. Allein die Beschreibung im Prompt hat gereicht. Genau deshalb wollte ich sie nicht gegen eine generierte Stimme tauschen, als eine Szene Probleme machte. Dort liegt jetzt eine einzelne nachvertonte Zeile über einem stummen Clip — die Ausnahme, die die Regel bestätigt.
Die Musik
Alle Clips sind bewusst ohne Musik generiert. H3 legt sonst pro Clip eigenen Score an, der an jeder Schnittstelle neu einsetzt und sich nachträglich nicht mehr von Stimme und Geräusch trennen lässt. Musik kommt über den fertigen Schnitt. Diese Entscheidung trifft man am ersten Tag und kann sie später nicht mehr korrigieren.
Mein erster Reflex war ein durchgehendes Bett aus Suno. Dagegen sprach die Struktur: In der Mitte des Films passiert zweieinhalb Minuten lang fünfmal dasselbe — ankommen, fragen, Absage mit Verweis auf den Nächsten. Ein gleichmäßiges Bett hätte die Monotonie verstärkt. Also sieben Cues:
| Cue | Abschnitt | Tempo |
|---|---|---|
| 1 | Auftakt und Kummer | 80 BPM |
| 2 | Die Suche, Hirsch und Biber | 100 BPM |
| R | Der Riese, läuft bis zur Eule durch | 66 BPM |
| E | Das Eichhörnchen | 132 BPM |
| 3 | Zwerge und Werkstatt | 112 BPM |
| 4a | Das Horn sitzt | 84 BPM |
| 4b | Magie und Schluss | 96 BPM |
Die Eule hat keinen eigenen bekommen, bei ihr läuft der Riesen-Cue weiter. Zwei kurze Clips rechtfertigen kein eigenes Stück.
Schau auf die Ausreißer: Riese 66 BPM, Eichhörnchen 132. Doppeltes Tempo. Niemand denkt beim Zuschauen darüber nach, aber jeder spürt die Figur, bevor sie den Mund aufmacht. Das ist klassische Filmmusik-Arbeit und hat mit KI nichts zu tun. Die KI macht nur das Ausführen billig genug, dass man sich sieben maßgeschneiderte Cues für ein privates Kinderprojekt überhaupt leistet.
Damit sieben Stücke nicht nach sieben Stücken klingen, bleibt die Instrumentierung gleich. In jedem Prompt steht „same storybook palette”:
gentle giant underscore, instrumental, same storybook palette of celesta harp
and pizzicato strings kept in the background, slow wide-interval theme on low
clarinet and cello, warm horn swell, timpani only very soft and sparse,
lumbering unhurried 66 BPM, big and kind and a little comic, never scary and
never threatening, no drum kit, midrange and low end left open, mixed far
beneath a spoken narrator and heavy footstep sound effects
Drei Details darin entscheiden mehr als der ganze Rest. „mixed far beneath a spoken narrator”, sonst baut Suno ein Stück, das vorne stehen will. Der freigehaltene Frequenzbereich — beim Riesen Mitten und Bässe offen für die Schritte, beim Eichhörnchen nur die oberen Lagen. Und „no drum kit”, „no build-up”, weil ein Spannungsaufbau dir jeden Schnitt zerschießt, der nicht genau auf dem Höhepunkt sitzt. Ins Exclude-Feld dazu vocals, choir, drums, EDM, epic trailer, tension risers, minor key drama.
Handarbeit bleibt trotzdem reichlich. Vier Varianten pro Cue, eine ausgewählt. Suno liefert zwei bis vier Minuten, der Cue braucht siebenunddreißig Sekunden, also wird geschnitten — deshalb steht „loopable” im Prompt. Übergänge laufen über ein bis zwei Sekunden Kreuzblende. Und am Ende alle sieben auf einen gemeinsamen Pegel ziehen und die Musik insgesamt absenken: Einzeln generierte Stücke kommen mit sieben verschiedenen Lautstärken, und das hört man genau an den Übergängen.
Zu den Rechten: entstanden mit Suno V5.5 auf dem Pro-Plan, der kommerzielle Nutzung inklusive YouTube abdeckt. Zwei Haken trotzdem. Suno garantiert kein durchsetzbares Urheberrecht an der Komposition — für einen Kinderfilm egal, für Kampagnenmusik keineswegs. Und seit September 2026 ist der Download das lizenzrelevante Ereignis statt der Generierung: Wer auf einem kostenlosen Account etwas Gutes erzeugt und erst danach upgradet, hat dafür keine kommerziellen Rechte.
Der Feinschliff, und warum er die eigentliche Arbeit ist
Hier der Punkt, den ich in jedem Workshop betone und der trotzdem regelmäßig überrascht:
Die reine Generierung kostet kaum Zeit. Von meinen 35 Stunden gingen unter drei fürs Generieren drauf. Du klickst, du wartest, du bekommst Clips. Das ist der einfache Teil.
Die Zeit steckt davor und danach. Davor in Konzeption und Prompts. Danach im Feinschliff, und der ist bei einem Film erheblich:
- Sequenzen auf die richtige Länge ziehen. Fast jeder generierte Clip ist am Anfang oder Ende ein paar Frames zu lang. Erst im Zusammenhang merkst du, wo es hakt.
- Ton schneiden. Die Erzählspur sitzt nicht automatisch auf den Bildern. Jeder Einsatz will einzeln platziert werden, und oft verschiebt sich dadurch der Bildschnitt.
- Pegel angleichen. Generierte Clips kommen mit sehr unterschiedlicher Lautstärke. Erzählstimme, Figurenstimmen, Umgebungsgeräusche und Musik müssen in eine gemeinsame Balance. Das ist klassische Tonarbeit, da hilft dir keine KI.
- Übergänge. Harte Schnitte funktionieren im Kinderfilm selten durchgehend. Ich habe an zwei Stellen mit einer Kreisblende gearbeitet, einmal am Ende auf einen lachenden Zwerg.
- Fade in, Fade out, Titel einblenden, und all die kleinen Dinge, die zusammen aus 34 Clips einen Film machen.


Rechne dafür ein Drittel deiner Gesamtzeit ein. Wer nur die Generierungszeit kalkuliert, verschätzt sich um den Faktor zehn.
Womit du schneidest
Geschnitten habe ich in CapCut, weil es schnell zur Hand war. Das funktioniert, und für einen ersten Film reicht es völlig.
Grundsätzlich geht der Schnitt in jedem Programm. Auch Canva kann das inzwischen, und Magnific hat einen eigenen Video-Editor an Bord, mit dem du die Clips direkt dort zusammenziehen kannst, wo sie entstanden sind. Für einen Rohschnitt ist das der kürzeste Weg.
Sobald es aber um Tonmischung, saubere Pegel und Farbangleichung geht, spielen Profiwerkzeuge ihre Stärke aus. DaVinci Resolve ist in der kostenlosen Version bereits eine vollwertige Schnitt- und Colorgrading-Suite mit ordentlicher Audiosektion. Adobe Premiere entsprechend, wenn du ohnehin in der Creative Cloud bist.
So gehst du es für dein Kind an
Fang mit dem Buch an. Der Film war nur machbar, weil Figuren, Geschichte und Look bereits standen. Ohne diese Grundlage generierst du dich in einen Wald aus hübschen Einzelbildern, die nicht zusammenpassen. Wie das Buch entsteht, steht hier.
1. Szenen schneiden, nicht Seiten übernehmen. Eine Handlung pro Clip. Aus meinen 13 Doppelseiten sind 34 Clips geworden, weil eine Buchseite oft zwei Dinge gleichzeitig erzählt. Dazu kamen vier Szenen, die im Buch gar nicht vorkommen, darunter ein Drohnenflug über den Wald als Einstieg, in dem die Eule an der Kamera vorbeifliegt.
2. Charaktersheets anlegen. Ein Referenzblatt pro Figur vor neutralem Hintergrund. Das ist die Versicherung gegen ein Pony, das in Clip 12 anders aussieht als in Clip 3. Diesen Schritt überspringt beim ersten Mal jeder.


3. Space aufsetzen und Claude anbinden. Eine Zeile pro Clip, Referenzen und Prompt daneben, Generator dahinter, Sammelliste am Ende. Der Aufbau kostet einen Nachmittag und trägt das ganze Projekt.
4. Startbilder im Zustand davor generieren. In 4K. Nimm dir für jedes Motiv vier Varianten und entscheide erst danach.
5. Prompts schreiben, die nichts auslassen. Bewegung für jedes Element, Ton für jede Szene, Ablauf explizit sequenziell, Sprache nur für Figuren mit sichtbarem Gesicht.
6. In 768p testen, in 2K finalisieren. Sitzt die Bewegung, ziehst du dieselbe Szene in hoher Auflösung nach. Rechne mit drei bis fünf Versuchen pro Clip, bei mir waren es meistens vier.
7. Ton getrennt bauen. Erzählstimme in Blöcken über 250 Zeichen, Musik separat über den fertigen Schnitt. Figurenzeilen im Clip mitgenerieren lassen, weil nur so die Lippenbewegung sitzt.
8. Schneiden und Zeit einplanen. Siehe oben. Das ist kein Nachklapp, das ist ein Drittel des Projekts.
Realistisch sind das ein paar Wochenenden.
Die Shotliste, mit der alles anfing
Bevor ein einziges Bild entstanden ist, stand diese Tabelle. Sie ist das eigentliche Fundament: Aus 13 Doppelseiten wurden 34 Einstellungen, jede mit genau einer Handlung, jede mit ihrem Text.
| Clip | Einstellung | Erzählstimme | Figurenzeile |
|---|---|---|---|
| 01a | Drohnenflug über den Wald, Eule fliegt vorbei | — | — |
| 01c | Mathilda geht in den Wald | Eines Tages geht Mathilda im Wald spazieren. | — |
| 01d | Close-up Mathilda | — | — |
| 02a | Totale Waldrand | Doch heute bleibt sie plötzlich stehen. Was sitzt denn da im Gras? Ein weißes Pony mit bunter Mähne. | — |
| 02b | Close-up weinendes Pony | — | Mathilda: Oh nein, warum weinst du denn so? |
| 03a | Detail Horn im Moos | Das Pony schluchzt nur und senkt den Kopf. Da entdeckt Mathilda etwas Goldenes im Moos. | — |
| 03a2 | Detail kahle Stirn | Und plötzlich versteht sie, was passiert ist. | — |
| 03b | Sie hebt das Horn auf | — | — |
| 03c | Halbnah, Horn wird gezeigt | — | Mathilda: Du bist jetzt ein Keinhorn. |
| 04 | Fahrt, Waldweg von hinten | Keine Sorge, sagt Mathilda, wir finden jemanden, der das repariert. Und der Wald ist wirklich sonderbar, voll Zauber, das ist beiden klar. | — |
| 05a | Totale Hirschfamilie | Da raschelt es im Gebüsch. Eine Hirschfamilie taucht auf. | Mathilda: Kannst du das reparieren? |
| 05b | Close-up Hirschkopf | — | Der Hirsch: So ein Horn kann ich nicht flicken. Fragt den Biber am Fluss! |
| 06a | Totale Biberdamm | Sie laufen weiter, immer dem Wasser nach. Am Fluss treffen sie den Biber. Er rückt die Brille zurecht. | Mathilda: Und du? Kannst du das kleben? |
| 06b | Close-up Biber mit Säge | — | Der Biber: Zu schwer für mich. Geht zum Riesen, der weiß Bescheid! |
| 07a | Der Riese stapft heran | Sie ziehen weiter. Da bebt der Waldboden. Zwischen den Stämmen kommt ein Riese auf sie zu, hoch wie ein Haus. | — |
| 07b | Totale, der Riese hält das Horn | — | Mathilda: Du, Riese, bekommst du das Horn wieder ans Keinhorn? |
| 07c | Detail Riesenhand | — | Der Riese: Viel zu fein für meine Pranken. |
| 07d | Close-up Mathilda und Pony | Die Zwerge könnten das reparieren, sagt der Riese. Aber die wollen ein Geschenk dafür. | Mathilda: Socken vielleicht? Selbstgestrickte? |
| 08a | Totale Eule | Da kichert es hämisch aus dem Baum. | Die Eule: Socken? Pah, Amateure! Zwerge wollen Gold. |
| 08b | Close-up Eule | — | Die Eule: Geht zum Eichhörnchen, das hat was für die Zwerge! |
| 09a | Eichhörnchen kommt näher | Ein Stück weiter im Wald hüpft ein Eichhörnchen von Ast zu Ast herunter und tippt hektisch auf seine Armbanduhr. | Mathilda: Hast du ein Geschenk für die Zwerge? |
| 09b | Close-up, Nuss aus dem Rucksack | — | Das Eichhörnchen: Hier, fangt den Schrott, die kann man eh nicht essen! |
| 09c | Detail, Hände fangen die Eichel | Sie fängt die goldene Zaubernuss mit beiden Händen. Gold — genau das, was die Zwerge wollen! | — |
| 10a | Totale, Zwerge streiten im leeren Hof | Mit dem Geschenk geht es nun zur Mine der Zwerge. Dort streiten drei, wer den schönsten Bart hat — für Arbeit keine Zeit. | — |
| 10a2 | Close-up erster Zwerg | — | Erster Zwerg: Geh weg, Kind! Wir haben Wichtigeres zu tun! |
| 10b | Totale, die Nuss wird gezeigt | — | Mathilda: Hier, eine Zaubernuss. Helft ihr mir dafür? |
| 10c | Close-up drei Zwergengesichter | — | Die drei Zwerge: Potzblitz! Kommt in die Werkstatt! |
| 11a | Totale Werkstatt, Horn in der Hand | In der Werkstatt herrscht Radau, man nimmt’s mit Ordnung nicht genau. Ein Zwerg stürzt in das Kleberfass, nur seine Füße sind nicht nass. | — |
| 11b | Detail, Horn wird angedrückt | — | Ein Zwerg: Das geht Ratzifatzi, mit dem Zauberkleber! |
| 12a | Totale Umarmung | Das Horn sitzt fest, juchhu, hurra. Das echte Einhorn ist wieder da. | — |
| 12b | Detail, das Horn leuchtet auf | Da sprüht Magie, ganz bunt und hell, und Blumen wachsen auf die Schnell. | — |
| 13a | Vor dem Zauberspruch | Und was ist nun aus den Zwergen und der Zaubernuss geworden? | Ein Zwerg: Abrakadabra, Nuss Nuss Nuss, mach meinen Bart zum Hochgenuss! |
| 13b | Close-up, dritter Zwerg lacht | Sie kichern laut, es wackelt der Bauch, Mathilda und das Einhorn auch. | — |
| 13c | Umarmung mit Horn | So endet die Reise, bunt und laut. Auf Wiedersehn, und danke, dass ihr zugeschaut! | — |
Zwei Dinge kann man an dieser Tabelle gut sehen. Erstens: Die Clips ohne jeden Text sind keine Lücken, sondern Atempausen — dort trägt das Bild allein. Zweitens: Fast jede Szene ist in zwei oder drei Einstellungen aufgeteilt. Eine Totale, die zeigt wo wir sind, dann ein Close-up für den Satz. Das ist klassische Filmgrammatik und es ist der Grund, warum aus 13 Buchseiten 34 Clips wurden.

Die drei Skills zum Mitnehmen
Was ich beim Prompten gelernt habe, steckt inzwischen in drei Claude-Skills, die ich in jedem neuen Projekt wiederverwende.
startbilder-fuer-videogenerierung kümmert sich um Frame 0: die Regel mit dem Zustand davor, Charaktersheets, das Ableiten neuer Einstellungen aus vorhandenen, warum lange Negativlisten nach hinten losgehen, und wann Bearbeiten besser ist als neu generieren.
minimax-h3-prompting enthält beide Promptformate mit vollständigen Vorlagen, die Audiosektions-Fallen, die Sprechtempo-Grenze und einen Fehlerkatalog: Symptom, Ursache, Behebung. Dazu eine Prüfliste, die sich vollständig automatisieren lässt — bei mir läuft sie als Skript über alle Prompts, bevor auch nur einer abgeschickt wird.
elevenlabs-v3-prompting enthält den Audio-Tag-Katalog, die 250-Zeichen-Regel, die Arbeit mit Interpunktion als Regieanweisung und die Besonderheiten bei deutschen Texten.
Ein Skill ist nichts anderes als eine Markdown-Datei mit Anweisungen und einer Beschreibung, wann sie gilt. Claude lädt sie automatisch, sobald das Thema im Gespräch aufkommt. Der eigentliche Wert liegt nicht in der Technik, sondern darin, dass gelöste Probleme nicht wieder verloren gehen. Jede Regel in diesen Dateien steht dort, weil vorher etwas kaputt war.
Kostenlos zum Herunterladen
Die drei Skills aus diesem Projekt
Als ZIP mit der jeweiligen SKILL.md. Ohne Anmeldung, ohne Formular.
- Startbilder-Skill herunterladenFrame 0, Charaktersheets, Konsistenz über ganze Szenenfolgen.
- Minimax-H3-Prompting-Skill herunterladenBeide Promptformate, Fehlerkatalog, Prüflisten.
- ElevenLabs-v3-Prompting-Skill herunterladenAudio-Tags, 250-Zeichen-Regel, Stability, deutsche Besonderheiten.
Zum Einbauen in Claude den jeweiligen Ordner ins Skills-Verzeichnis legen, fertig.
Und sie funktionieren nicht nur in Claude. Drinnen steht ganz normales Markdown, kein herstellerspezifisches Format. In ChatGPT hinterlegst du den Inhalt als Projektanweisung oder legst die Datei einem Custom GPT als Wissen bei. In Langdock, Gemini oder jedem anderen Assistenten geht derselbe Weg: als Systemanweisung, als Dokument in der Wissensbasis oder einfach am Anfang der Unterhaltung eingefügt. Der Effekt ist überall derselbe, nur dass Claude die passende Datei selbst erkennt und die anderen sie einmal pro Projekt oder Unterhaltung brauchen.
Und ja, anpassen ist erwünscht. Alle drei sind auf ein Aquarell-Kinderbuch hin geschrieben. Der Stilsatz und die Figurenbeschreibungen gehören ausgetauscht, sobald du an etwas anderem arbeitest. Die Struktur und der Fehlerkatalog bleiben gültig.
Was davon im Marketing zählt
Ein Kinderfilm ist kein Kundenprojekt. Die Probleme sind trotzdem exakt dieselben.
Konsistenz ist die eigentliche Arbeit. Eine Figur, die über 34 Clips gleich aussehen muss, ist technisch dasselbe wie ein Testimonial, das über eine ganze Kampagne gleich aussehen muss. Der Aufwand steckt im System dahinter: Referenzen, Regeln, Prüfschritte, eine Werkbank, auf der man eingreifen kann.
Der Mensch muss an die Werkbank kommen. Automatisierung, die dir die Zugriffsmöglichkeit nimmt, ist bei Kreativarbeit keine Automatisierung, sondern ein Risiko. Genau deshalb baue ich den MCP so, dass er im Space arbeitet und nicht im Verborgenen.
Die Auflösung ist eine Qualitätsentscheidung, keine Kostenfrage. Der Sprung von 768p auf 2K hat bei mir mehr fürs Ergebnis gebracht als jede Prompt-Optimierung. Wer bei der Auflösung spart, spart an der falschen Stelle. Die Credits sind billiger als deine Zeit.
Das Auge bleibt der Flaschenhals. Alle Regeln oben sind im Kern Gestaltungsfragen. Ob ein Startbild den richtigen Moment zeigt, sieht nur, wer weiß, wie eine Szene funktioniert. Die Modelle werden in den nächsten Monaten deutlich besser. An dieser Stelle ändert das nichts.
Wenn du das mit deinem Team aufbauen willst
Genau so arbeiten wir im KI Marketing Bootcamp. Für ganze Abteilungen machen wir Seminare vor Ort oder remote, an euren echten Cases. Für einzelne Teilnehmer laufen unsere Weiterbildungen live und online, wer tief in Bild und Video will, ist beim AI Visual Engineer richtig.
Und falls du das für dein eigenes Kind angehst: Schreib mir, wie weit du kommst. Ich bin neugierig, an welcher Stelle es bei dir hakt.
Stand September 2026. Bei dem Tempo, das die Videomodelle vorlegen, ist die Hälfte der Workarounds in einem halben Jahr überflüssig. Die Sache mit Frame 0 wird bleiben.
Weiterdenken
Ihr wollt solche Bildwelten selbst produzieren?
Statt bei jedem Motiv neu zu würfeln, bauen wir in KI Studio einen Prozess, der eure Marke zuverlässig trifft, auch bei der zwanzigsten Variante.
 AI
Grafikdesigner, Dozent für generative Bild-KI und Keynote Speaker. Leitet das KI Studio von uncanny minds und ist Co-Autor des O'Reilly-Buchs Content Marketing mit KI.
Weiterlesen
Das könnte dich auch interessieren.
- 01
 KI im Einsatz
Opus 5.5 als Motion Designer
Vroni hat Claude Opus 5.5 ein Motion-Graphics-Video über UNCANNY MINDS bauen lassen. Ein Prompt, ein Versuch, kein Nachbessern. Hier ist das Ergebnis und was es zeigt.
- 02
 KI im Einsatz
Corporate Design mit KI
Wie aus Dachmarke, Farben, Typografie und Riffelglas die visuelle Identität von UNCANNY MINDS entstand.
- 03
 KI im Einsatz
Website mit KI bauen
Die Making-of-Serie zum Website-Relaunch von UNCANNY MINDS: Corporate Design, KI-Prototyping, technische Basis und Auffindbarkeit.